Не просто Diff: как алгоритмы сравнивают тексты на уровне символов, слов и семантики

Сравнение текстов — одна из базовых задач современной разработки, анализа данных и обработки естественного языка. Программисты используют
git diff, чтобы увидеть изменения в исходном коде, редакторы документов помогают находить исправления, а поисковые системы сопоставляют запросы пользователей с содержимым баз данных. Внешне все эти инструменты решают одну задачу, но внутри могут работать совершенно разные алгоритмы.Разница становится особенно заметной, когда нужно сравнить не отдельные строки, а большие документы, обнаружить небольшую опечатку, определить структурные изменения в программе или установить, насколько два текста близки по смыслу. Для каждой из этих задач существуют специализированные методы: от классического алгоритма Майерса до сравнения абстрактных синтаксических деревьев и нейросетевых моделей, преобразующих текст в числовые представления.
Чтобы оценить работу подобных инструментов на практике, необязательно устанавливать сторонние программы или разрабатывать собственное решение. Например, можно сравнить тексты в онлайн-сервисе Mapleshee - вставить два текста и посмотреть, какие различия обнаруживает инструмент. Такой эксперимент помогает понять принцип сравнения, а заодно увидеть, почему результат зависит от того, на каком уровне анализируются данные.
Мы же в данной статье рассмотрим четыре основных подхода: построчное сравнение, анализ отдельных символов, структурное сопоставление программного кода и семантический анализ. Каждый из них решает определённый круг задач, а выбор подходящего метода зависит от того, что именно требуется обнаружить.

Уровень 1. Построчный анализ: как работает классический Diff
Построчное сравнение — один из наиболее распространённых способов поиска различий между текстовыми файлами. Его используют системы контроля версий, инструменты проверки изменений и многие редакторы кода. Главная идея проста: программа сопоставляет строки двух версий документа, определяет совпадающие участки и показывает, какие строки были добавлены, удалены или изменены.
Такой подход особенно удобен для исходного кода, конфигурационных файлов, журналов событий и обычных текстовых документов, где перенос строки часто соответствует отдельному логическому элементу. При этом построчный алгоритм не обязательно понимает содержание текста: он анализирует последовательности и ищет наиболее рациональный способ показать переход от одной версии к другой.
Алгоритм Майерса и поиск минимальных изменений
Один из известных алгоритмов для построения различий между последовательностями — алгоритм Майерса (Myers diff algorithm). Он используется в различных инструментах сравнения и лежит в основе многих реализаций diff-подобных алгоритмов, хотя конкретные программы могут применять дополнительные эвристики и другие стратегии.
Алгоритм Майерса решает задачу поиска кратчайшего сценария преобразования одной последовательности в другую. Если сравниваются два файла, такими последовательностями могут выступать их строки. Алгоритм ищет совпадающие элементы и определяет, какие вставки и удаления необходимы, чтобы получить новую версию из старой с минимальным количеством операций.
Для наглядности задачу можно представить в виде сетки. По горизонтали располагаются элементы первой последовательности, по вертикали — второй. Диагональный шаг соответствует совпадению элементов, а горизонтальные и вертикальные шаги отражают удаление или вставку. Поиск подходящего пути позволяет определить последовательность правок, не перечисляя каждое возможное преобразование.
Здесь важно различать два понятия. Наибольшая общая подпоследовательность (Longest Common Subsequence, LCS) — это наиболее длинная последовательность элементов, которые встречаются в обоих текстах в одинаковом порядке, хотя между ними могут находиться другие элементы. Кратчайший сценарий вставок и удалений тесно связан с этой задачей: чем больше общих элементов удаётся сохранить, тем меньше операций требуется для преобразования.
Например, если старая версия содержит строки
load_config(), connect_db() и start_server(), а новая — те же строки, но с дополнительным вызовом validate_config(), алгоритм может показать одну вставку, сохранив остальные совпадающие строки. Это гораздо нагляднее, чем выводить весь файл как полностью изменённый.Почему Diff не всегда показывает изменения так, как ожидает человек
Построчный анализ хорошо работает, пока структура документа остаётся относительно стабильной. Но если разработчик перемещает большой блок кода, переписывает несколько абзацев или меняет форматирование, результат может оказаться менее очевидным. Алгоритм должен решить, какие строки считать совпадающими, а какие — удалёнными и добавленными. В некоторых случаях разные варианты сопоставления дают одинаково короткий сценарий изменений, поэтому итоговое представление зависит от особенностей реализации.
Допустим, функция из двадцати строк переместилась из начала файла в конец. Один инструмент может распознать сходство перемещённого блока, другой покажет его как удаление и последующую вставку. Сам по себе классический diff не обязан распознавать перенос как самостоятельную операцию: чаще всего его базовые действия — вставка и удаление, а поиск перемещённых блоков реализуется дополнительными механизмами.
Похожая ситуация возникает при изменении одной буквы внутри длинной строки. Если инструмент работает исключительно на уровне строк, он может подсветить всю строку как изменённую, даже если различается только один символ. Чтобы получить более подробную картину, необходимо дополнительно анализировать содержимое совпадающих или изменённых строк.
Преимущества и ограничения построчного сравнения
Основное достоинство классического diff — эффективность. Он позволяет быстро сопоставлять последовательности строк, сохранять понятную историю изменений и формировать удобные патчи для применения в системах контроля версий. Для Git и аналогичных инструментов это особенно важно: разработчику нужно не только увидеть различия, но и понять, какие изменения следует включить в коммит, перенести в другую ветку или проверить при рецензировании кода.
Однако построчный анализ не оценивает смысл текста и не всегда детализирует изменения внутри строки. Он также чувствителен к структуре документа: массовое изменение форматирования, переносов строк или порядка блоков может затруднить чтение результата.
Поэтому классический diff остаётся отличным базовым инструментом, но для поиска отдельных опечаток, сравнения похожих слов или анализа перестановок его возможностей может оказаться недостаточно.
Уровень 2. Посимвольный анализ: расстояние Левенштейна
Если построчное сравнение показывает, какие строки различаются, посимвольные алгоритмы позволяют выяснить, насколько именно различаются слова или короткие фрагменты. Это важно для проверки орфографии, нечёткого поиска, автоматического исправления опечаток, сопоставления пользовательского ввода с каталогом и обработки данных, в которых возможны небольшие ошибки.
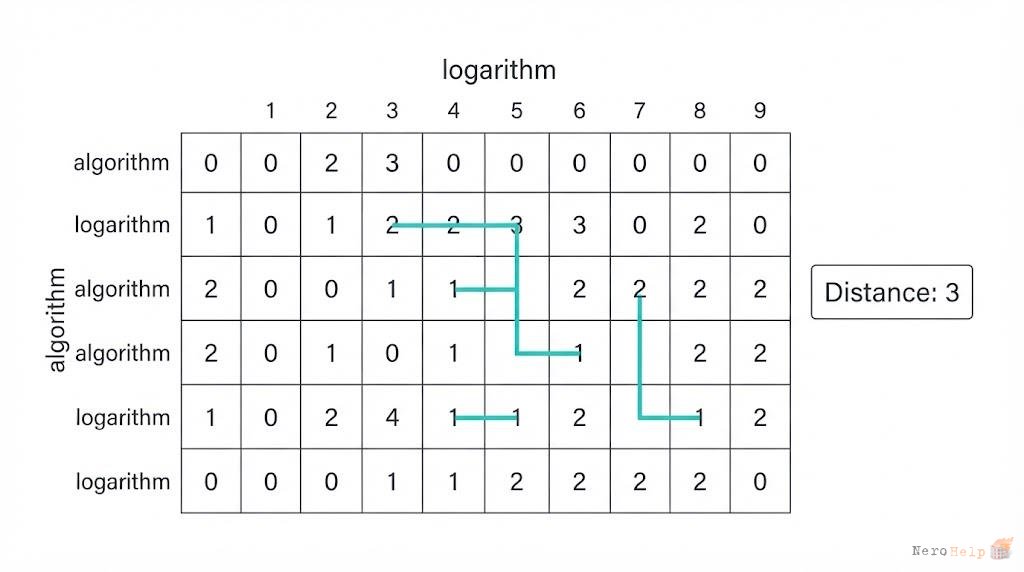
Один из наиболее известных методов — расстояние Левенштейна. Оно измеряет минимальное количество операций вставки, удаления и замены символов, необходимых для преобразования одной строки в другую. В отличие от простого подсчёта несовпадающих позиций, этот метод учитывает, что символы могут сдвигаться из-за вставок и удалений.
Как вычисляется расстояние Левенштейна
Для расчёта обычно используется динамическое программирование. Алгоритм строит матрицу, в которой каждая ячейка отражает минимальную стоимость преобразования одного префикса строки в другой. Начальная строка и столбец заполняются значениями, соответствующими удалению или добавлению символов. Затем программа последовательно вычисляет стоимость каждой следующей операции.
Для каждой пары символов рассматриваются три варианта: удалить символ из первой строки, вставить символ во вторую или сопоставить символы, при необходимости выполнив замену. Если символы совпадают, стоимость сопоставления равна нулю; если различаются, замена добавляет одну операцию. В ячейку записывается минимальная стоимость из доступных вариантов.
Рассмотрим несколько примеров:
- •
котикит— расстояние равно 1, поскольку достаточно заменить одну букву. - •
котикоты— расстояние равно 1, поскольку требуется вставить один символ. - •
котикитздесь отличается только одна буква, а значит, расстояние также равно 1 независимо от того, насколько слова близки по значению.
Последний пример подчёркивает принципиальную особенность алгоритма: он измеряет формальное расстояние между последовательностями символов, а не смысловую близость. Слова «кот» и «кит» отличаются на одну замену, но обозначают разных животных. И наоборот, два близких по смыслу выражения могут иметь большое редакционное расстояние.
Где применяется редакционное расстояние
Расстояние Левенштейна полезно в системах проверки орфографии. Если пользователь вводит название товара с опечаткой, поиск может сравнить введённую строку с названиями в каталоге и предложить варианты с небольшим редакционным расстоянием. Например, запрос
смартфон самсунг можно сопоставлять с вариантами написания бренда, учитывая пропущенные, добавленные или заменённые символы.Подобные методы применяются и при обработке персональных данных, адресов, названий организаций и других текстовых полей, в которых возможны опечатки. В биоинформатике родственные алгоритмы используются для сравнения последовательностей ДНК и белков, хотя для таких задач могут применяться специальные модели, учитывающие особенности биологических данных.
При этом расстояние Левенштейна — не единственная метрика для нечёткого сравнения. Например, расстояние Дамерау — Левенштейна дополнительно учитывает перестановку соседних символов. Это удобно для типичной ошибки при наборе текста, когда две соседние буквы случайно меняются местами. Метрика Джаро — Винклера, в свою очередь, часто применяется для оценки сходства коротких строк и имён.
Вычислительная сложность и ограничения
Для строк длиной (M) и (N) классический алгоритм Левенштейна использует (O(MN)) времени. Если сравниваются два слова по десять символов, объём вычислений невелик. Но при переходе к длинным документам число ячеек матрицы быстро растёт: две строки по 10 000 символов потребуют порядка 100 миллионов вычисляемых состояний при прямом использовании стандартного динамического алгоритма.
Это не означает, что любой файл размером 10 МБ обязательно зависнет при сравнении. Реальная производительность зависит от реализации, объёма памяти, алгоритмических оптимизаций и способа предварительной обработки текста. Тем не менее применять базовый посимвольный алгоритм ко всему большому документу обычно нерационально, если задача сводится к поиску изменённых строк.
На практике посимвольное сравнение часто используют после предварительного этапа. Сначала программа находит соответствующие строки или похожие блоки, а затем применяет редакционное расстояние только к выбранным фрагментам. Такой гибридный подход позволяет получить подробную подсветку изменений без необходимости сравнивать каждую букву каждого документа со всеми остальными.
Уровень 3. Структурный анализ: AST-Diff для программного кода
Обычное текстовое сравнение воспринимает программу как последовательность символов и строк. Но для компилятора или интерпретатора исходный код — это ещё и структура, состоящая из выражений, функций, условий, циклов, объявлений переменных и других языковых конструкций. Если требуется понять, что изменилось именно в программе, а не только в её текстовом представлении, полезно сравнивать синтаксическую структуру.
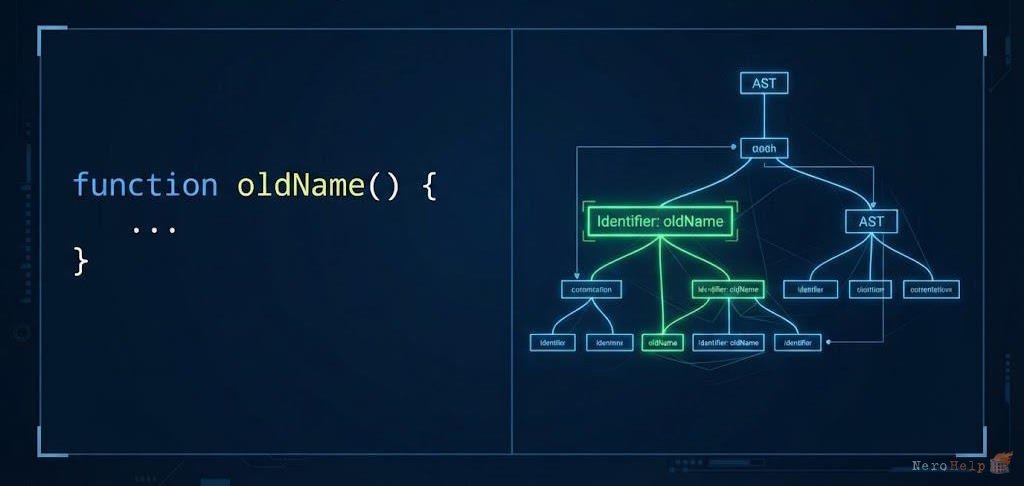
Для этой задачи применяются методы структурного сравнения, в том числе AST-Diff. Они сопоставляют абстрактные синтаксические деревья двух версий кода и пытаются определить, какие узлы были добавлены, удалены, перемещены или изменены. Благодаря этому можно получить представление о правках, которое лучше соответствует логике программного языка.
Что такое абстрактное синтаксическое дерево
AST (Abstract Syntax Tree) — это структурированное представление исходного кода в виде дерева. Каждый узел обозначает определённую языковую конструкцию, а связи между узлами отражают отношения вложенности и порядка, необходимые для интерпретации программы.
Например, выражение
total = price + tax можно представить как узел присваивания, у которого слева находится переменная total, а справа — узел сложения с операндами price и tax. В более крупной программе дерево включает функции, параметры, блоки команд, циклы, условные выражения и вызовы других функций.При построении AST парсер анализирует синтаксис языка и формирует структуру, в которой обычно не сохраняются все детали исходного форматирования. Пробелы, отступы и некоторые комментарии могут отсутствовать в дереве, поскольку они не влияют на синтаксическую структуру программы. Однако конкретные возможности зависят от парсера: инструменты, предназначенные для редактирования кода, могут сохранять больше информации об исходном тексте.
Именно здесь возникает преимущество структурного сравнения. Если разработчик изменил отступы или перенёс выражение на другую строку, AST может остаться практически прежним. Если же он заменил операцию сложения на вычитание, структура дерева изменится в соответствующем узле, даже если большая часть исходного текста совпадает.
Как AST-Diff находит изменения
Сначала обе версии исходного кода разбираются парсером, который строит соответствующие синтаксические деревья. Затем алгоритм пытается сопоставить узлы этих деревьев. Он учитывает типы конструкций, их содержимое, связи с родительскими узлами и положение в структуре. На основании полученных соответствий строится набор операций, описывающих изменения между версиями.
Для этой задачи существуют разные алгоритмы сравнения деревьев. Например, классические алгоритмы редактирования деревьев, включая подходы Чжана — Шаши, позволяют находить последовательности операций для преобразования одного дерева в другое. Инструмент GumTree ориентирован на обнаружение изменений в исходном коде и использует сопоставление узлов, чтобы выявлять такие операции, как перемещение, добавление, удаление и обновление элементов.
Представим, что функция
calculate_total() перенесена из одного места файла в другое без изменения содержимого. Простой построчный diff может отобразить блок как удалённый в прежней позиции и добавленный в новой. Структурный инструмент при удачном сопоставлении способен определить, что речь идёт о том же фрагменте программы, который переместили.Но есть важное ограничение: обнаружение перемещений не гарантировано само по себе. Если функция сильно переписана, её имя изменено или внутренние узлы существенно отличаются, алгоритм может не распознать исходный блок. Результат зависит от стратегии сопоставления, особенностей языка и конкретной реализации.
Чем структурное сравнение полезно при Code Review
При проверке изменений кода важно понимать, какие конструкции программы были затронуты. Если разработчик переместил функцию, изменил порядок методов или отформатировал большой блок, структурный diff может уменьшить количество визуального шума и помочь сосредоточиться на реальных изменениях логики.
AST-Diff также полезен при анализе рефакторинга, исследовании истории изменений и создании инструментов автоматической проверки кода. Например, система может обнаружить, что в условии изменился оператор сравнения, в вызов функции добавился аргумент или изменился тип выражения. Это более содержательный результат, чем простая подсветка изменённых строк.
При этом структурное сравнение не следует путать с полноценным доказательством эквивалентности программ. Два фрагмента могут иметь похожую структуру, но разное поведение. И наоборот, две программы с совершенно разным синтаксическим представлением могут выполнять одну задачу. Чтобы оценивать поведение кода, могут потребоваться дополнительные методы: статический анализ, тестирование, анализ потока данных или формальная верификация.
Зависимость от языка программирования
AST-Diff нуждается в корректном синтаксическом разборе исходного кода. Для javascript, Python, Rust, Java и других языков требуются соответствующие парсеры или инструменты, понимающие их грамматику. Универсальный текстовый diff способен сравнить любой файл как последовательность символов, а структурный инструмент должен знать правила построения синтаксических конструкций.
Это ограничение особенно заметно при работе с несколькими языками в одном проекте. Если система сравнивает исходный код, конфигурации, шаблоны и SQL-запросы, ей могут потребоваться разные механизмы разбора. Кроме того, AST не всегда учитывает семантику программы: для понимания типов, разрешения имён и связей между модулями часто нужны более сложные представления, например семантическая модель или граф зависимостей.
Поэтому AST-Diff лучше всего подходит для структурного анализа кода, но не заменяет обычный diff во всех ситуациях. Для просмотра небольшого патча стандартное построчное сравнение зачастую проще и быстрее, а структурные методы особенно полезны при масштабном рефакторинге и разработке интеллектуальных инструментов Code Review.
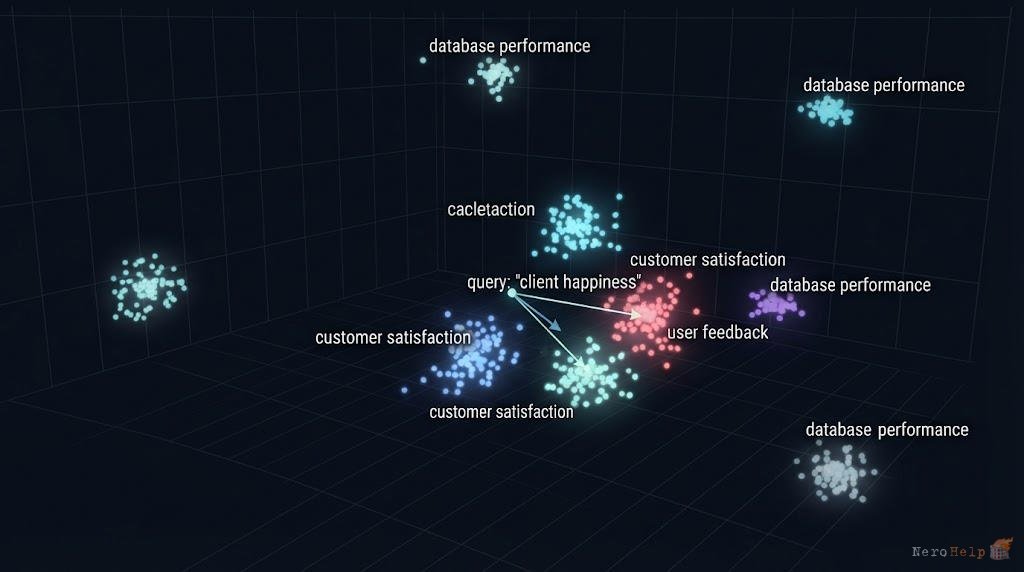
Уровень 4. Семантическое сравнение: эмбеддинги и искусственный интеллект
Текст может значительно измениться внешне, сохранив исходную мысль. Например, фразы «Разработчик пишет код на ноутбуке» и «Инженер программирует за компьютером» используют разные слова, но описывают близкую ситуацию. Для посимвольных алгоритмов такие предложения могут различаться довольно сильно, тогда как человеку очевидно их смысловое сходство.
Семантическое сравнение предназначено для оценки того, насколько тексты близки по значению. Для этого применяются языковые модели и методы машинного обучения, способные учитывать контекст, связи между словами и смысл целых фрагментов. Такой подход используют в интеллектуальном поиске, рекомендательных системах, обработке обращений пользователей и других задачах, где точного совпадения формулировок недостаточно.
Как текст превращается в числовой вектор
Один из распространённых подходов основан на эмбеддингах — числовых представлениях текста, которые формирует обученная модель. В отличие от простого кодирования символов, эмбеддинг старается отразить особенности значения фразы или документа в виде набора чисел.
Например, предложение может быть преобразовано в вектор из нескольких сотен или тысяч числовых значений. Точная размерность зависит от выбранной модели: нельзя считать, что все современные языковые модели используют одинаковое количество координат. Сам по себе вектор не содержит понятных человеку подписей вроде «тема — программирование» или «действие — написание кода». Его значения интерпретируются в контексте пространства, сформированного при обучении модели.
Если модель обучена так, чтобы тексты с похожим смыслом получали близкие представления, можно сравнивать их векторы. Для этого часто используют косинусное сходство, которое оценивает угол между двумя векторами и не зависит напрямую от их абсолютной длины.
В упрощённом виде формула выглядит так:
Косинусное сходство = скалярное произведение двух векторов / произведение длин этих векторов.
Здесь векторы A и B представляют числовые характеристики двух текстов. Скалярное произведение учитывает значения соответствующих компонентов векторов, а их длины используются для нормализации результата. Благодаря этому можно сравнивать тексты по смысловой близости, даже если они содержат разные слова и формулировки.
Для ненулевых векторов косинусное сходство лежит в диапазоне от −1 до 1. На практике в некоторых системах эмбеддингов значения часто находятся в более узком диапазоне, но это зависит от модели и данных. Чем выше показатель в рамках выбранной системы, тем ближе обычно оказываются представления текстов. Однако единого порога, после которого любые два предложения можно считать одинаковыми по смыслу, не существует.
Почему синонимы и перефразирования могут считаться похожими
Смысловая модель не ограничивается подсчётом совпадающих слов. Она обучается на большом количестве текстовых примеров и формирует представления, учитывающие контекстные связи. Поэтому фразы с разными словами могут оказаться близкими в векторном пространстве, если модель научилась распознавать сходство их содержания.
Например, «Компания открыла новый офис» и «Организация начала работу в дополнительном помещении» различаются лексически, но описывают похожее событие. Для классического diff и расстояния Левенштейна совпадений может быть мало, тогда как модель эмбеддингов способна оценить смысловую близость.
Однако качество результата зависит от языка, предметной области, длины текста и обучающих данных. Модель может хорошо сравнивать обычные предложения, но хуже справляться с узкоспециализированной терминологией, редкими именами, юридическими оговорками или сложными техническими деталями. Поэтому семантическое сходство следует интерпретировать как оценку, а не как безошибочное понимание текста.
Где применяется семантический diff
Семантическое сравнение особенно полезно в системах поиска, где пользователь может описывать нужный материал другими словами. Вместо поиска только по точным совпадениям система преобразует запрос и документы в эмбеддинги, после чего ранжирует результаты по близости векторных представлений. Это помогает находить материалы, которые отвечают на вопрос, даже если в них используются другие формулировки.
Другой пример — анализ отзывов и обращений в службу поддержки. Сообщения «Не могу войти в аккаунт» и «После ввода пароля доступ не открывается» отличаются по словам, но могут описывать одну проблему. Семантические модели помогают группировать похожие обращения, искать дубликаты и направлять запросы в соответствующие категории.
Подобные методы применяют и для предварительного поиска потенциально похожих документов. Но семантическое сходство не доказывает плагиат: два текста могут описывать один и тот же факт или общедоступную информацию без заимствования друг у друга. Для полноценной проверки необходимо учитывать совпадения формулировок, структуру, источники и другие признаки.
Почему нейросеть не заменяет точный Diff
Главное ограничение семантического сравнения заключается в том, что смысловая близость не равна текстовой идентичности. Модель может считать два фрагмента очень похожими, даже если в одном из них есть существенная ошибка, изменённое число или отрицание.
Например, предложения «Система разрешает удаление файлов» и «Система запрещает удаление файлов» различаются одним словом, но смысл у них противоположный. В некоторых контекстах их векторные представления всё равно могут оказаться достаточно близкими, поскольку значительная часть слов и общая тема совпадают. Аналогично нейросетевой метод не должен использоваться как единственный способ поиска изменений в математических формулах, исходном коде или финансовых данных, где один символ может полностью изменить результат.
Есть и практические требования. Генерация эмбеддингов требует вычислительных ресурсов, а при использовании внешнего API может зависеть от тарификации, сетевой задержки и условий обработки передаваемых данных. Для больших корпусов документов дополнительно строят векторные индексы, чтобы не пересчитывать сходство каждой пары текстов при каждом запросе. Такие технологии, как векторные базы данных, помогают хранить представления и быстро находить ближайшие элементы, но сами по себе не выполняют универсальное сравнение всех смысловых изменений между двумя документами.
Поэтому семантические методы лучше рассматривать как дополнение к классическим алгоритмам. Они отвечают на вопрос «Насколько близки тексты по смыслу?», тогда как обычный diff отвечает на другой вопрос: «Что конкретно изменилось?».
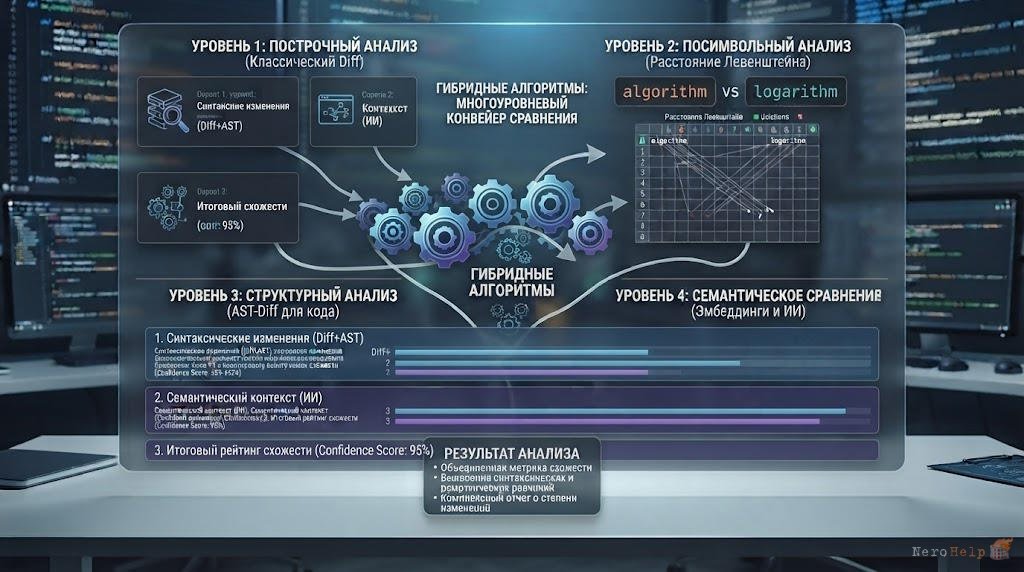
Гибридные алгоритмы: почему на практике используют несколько уровней сравнения
В реальных приложениях четыре описанных подхода не обязательно конкурируют друг с другом. Часто наиболее полезный результат даёт последовательное применение нескольких алгоритмов: сначала программа определяет совпадающие блоки, затем находит различия внутри строк, анализирует структуру или оценивает смысловую близость там, где это действительно нужно.
Например, при сравнении двух версий технической документации можно сначала выполнить построчный diff, чтобы быстро обнаружить изменённые разделы. Затем посимвольный алгоритм поможет выделить точные правки внутри абзацев. Если требуется проверить, не изменился ли смысл инструкции после перефразирования, можно дополнительно применить семантическую модель. При анализе программного кода вместо последнего этапа может оказаться полезнее AST-Diff.
Как выбрать последовательность алгоритмов
Выбор зависит от цели и объёма данных. Для просмотра изменений в репозитории обычно достаточно классического diff. Для исправления опечаток нужен алгоритм редакционного расстояния или другая метрика сходства строк. Для анализа рефакторинга стоит рассмотреть структурное сравнение, а для смыслового поиска по большому массиву документов — эмбеддинги и векторный поиск.
Если сравниваются длинные тексты, полезно заранее определить, какие фрагменты следует сопоставлять. Разбивка документа на строки, абзацы или смысловые блоки может уменьшить объём вычислений и сделать результат понятнее. При этом слишком агрессивное разбиение способно потерять контекст: отдельное предложение иногда становится неоднозначным, если рассматривать его без предыдущего абзаца.
Важен и формат данных. Для кода следует учитывать язык программирования и синтаксические особенности, для документов — структуру заголовков и абзацев, а для пользовательского поиска — возможные опечатки и перефразирования. Универсальный алгоритм, одинаково хорошо решающий все эти задачи, на практике оказывается менее эффективным, чем набор специализированных методов.
Сравнение подходов: какой алгоритм выбрать для конкретной задачи?
Разница между методами становится особенно наглядной, если сопоставить их назначение, преимущества и ограничения. Таблица ниже показывает типичные сценарии применения, но не является строгой классификацией: реальные инструменты могут комбинировать несколько подходов.
| Задача | Подход | Примеры технологий | Основное ограничение |
|---|---|---|---|
| Просмотр изменений в файлах и контроль версий | Построчный diff | Git diff, алгоритм Майерса и другие стратегии сопоставления | Может показывать перемещённый блок как удаление и вставку |
| Поиск опечаток и похожих строк | Посимвольное сравнение | Расстояние Левенштейна, Дамерау — Левенштейна, Джаро — Винклера | Не понимает смысл слов и предложений |
| Анализ рефакторинга и изменений в коде | Структурное сравнение | AST-Diff, GumTree, языковые парсеры | Зависит от языка и качества сопоставления деревьев |
| Поиск похожих документов и перефразирований | Семантическое сравнение | Эмбеддинги, косинусное сходство, векторный поиск | Не гарантирует точного обнаружения всех смысловых различий |
| Сопоставление больших документов с детальной подсветкой правок | Гибридный подход | Diff вместе с посимвольным и/или семантическим анализом | Требует более сложной логики и настройки |
***
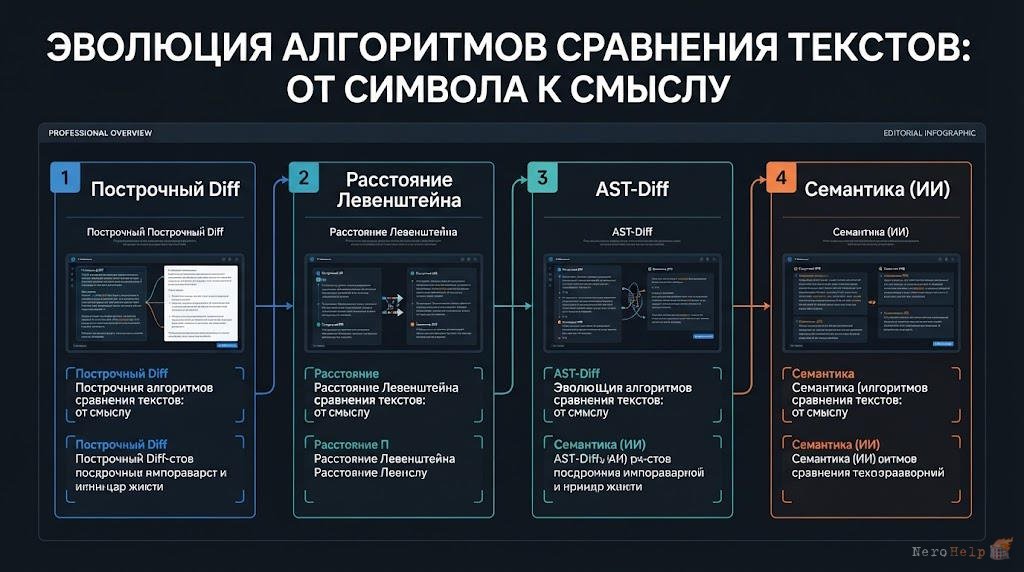
Сравнение текстов — это не один алгоритм, а целое семейство методов, каждый из которых рассматривает данные на своём уровне. Построчный diff помогает быстро увидеть изменения в документе, расстояние Левенштейна измеряет различия между строками, AST-Diff анализирует структуру программного кода, а эмбеддинги позволяют оценивать сходство по смыслу.
Выбор подхода должен начинаться с простого вопроса: что именно требуется найти? Если нужно показать добавленные и удалённые строки, нет смысла запускать нейросеть. Если требуется обнаружить небольшую опечатку, посимвольная метрика окажется полезнее семантической оценки. Если же формулировки сильно различаются, но важно найти документы на одну тему, векторные представления могут дать более подходящий результат.
На практике эти технологии дополняют друг друга. Понимание их сильных сторон помогает не только выбирать готовые инструменты, но и проектировать собственные системы сравнения — от простых редакторов до интеллектуальных поисковых сервисов. А чтобы увидеть, как различия отображаются в реальном интерфейсе, можно начать с онлайн-инструмента MapleSheet и проверить несколько собственных примеров.