Cuneiform: оптическое распознавание текста
Содержание:
1. Предисловие;
2.Оптическое распознавание текста (Вы читаете данный раздел);
3. CuneiForm в наши дни;
4. Linux-порт CuneiForm.

В решении задачи оптического распознавания текста есть два похода. Первый, наиболее простой (на словах) - матричное распознавание, или распознавание по образцу. У нас есть картинка с текстом и где-то в памяти мы храним алфавит, эталонный набор картинок-символов. Мы разбиваем изображение с текстом на элементы (предполагая в каждом из них букву) и сравниваем эти элементы с элементами алфавита. При каждом сравнении определяется степень схожести элемента текста с каждым из элементов шаблонного алфавита. Кто имеет наивысшую степень подобия, тот и есть искомая буква. Другой подход сложнее. Программа-распознаватель тоже содержит образцовый алфавит, однако он представлен не графикой, а правилами начертания символа. То есть, букву А можно описать как «палочка 1, наклоненная вправо, и палочка 2, наклоненная влево, и между ни-ми горизонтальная палочка 3».
На Западе матричный или «паттерновый» метод распознавания применялся еще в 60-х годах. Был даже разработан стандартный моноширинный шрифт OCR-A, применяющийся, например, в банковских чеках. Минусы метода - начертание букв, передаваемых распознающей программе, должно быть ей заранее известно или по крайней мере быть подобным в имеющихся у нее образцах шрифтов (чтобы было, с чем сравнивать).
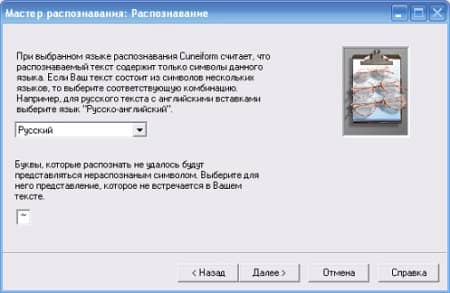
Второй подход - по идее, наиболее эффективный, поскольку не требует привязки к шрифту. Однако и наиболее сложный - ведь алгоритму необходимо «разложить» предполагаемые буквы на составляющие начертания. И не только в разложении трудности. Строки текста ведь не всегда идут строго прямо, особенно в сканированных источниках. Еще шрифты бывают разных размеров., а некоторые буквы похожи на другие буквы и на цифры. Как отличить английскую «а» от русской? Нужен уже словарь - программа будет пытаться сложить рас-познанные символы в слова и сверять каждое слово с образцами из словаря.
Каково современное состояние ПО для распознавания текста? Кого об этом ни спросишь, все называют одну и ту же программу - FineReader. В прошлом же называли CuneiForm. Но вообще-то CuneiForm никуда не исчезла. Более того, её исходники стали открыты под BSD-подобной лицензией...
Заканчиваете делать ремонт в своей новой квартире и Вам совершенно не до изучения Cuneiform? Что ж, тогда я рекомендую Вам прямо сейчас приобрести отличные люстры (http://brille.ua/lyustry/), которые идеально впишутся в ваш обновленный интерьер! А самый широкий ассортимент люстр Вы найдете на brille.ua.
1. Предисловие;
2.
3. CuneiForm в наши дни;
4. Linux-порт CuneiForm.
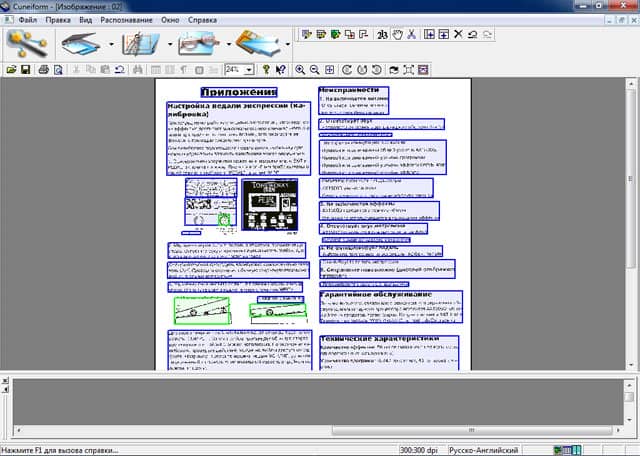
В решении задачи оптического распознавания текста есть два похода. Первый, наиболее простой (на словах) - матричное распознавание, или распознавание по образцу. У нас есть картинка с текстом и где-то в памяти мы храним алфавит, эталонный набор картинок-символов. Мы разбиваем изображение с текстом на элементы (предполагая в каждом из них букву) и сравниваем эти элементы с элементами алфавита. При каждом сравнении определяется степень схожести элемента текста с каждым из элементов шаблонного алфавита. Кто имеет наивысшую степень подобия, тот и есть искомая буква. Другой подход сложнее. Программа-распознаватель тоже содержит образцовый алфавит, однако он представлен не графикой, а правилами начертания символа. То есть, букву А можно описать как «палочка 1, наклоненная вправо, и палочка 2, наклоненная влево, и между ни-ми горизонтальная палочка 3».
На Западе матричный или «паттерновый» метод распознавания применялся еще в 60-х годах. Был даже разработан стандартный моноширинный шрифт OCR-A, применяющийся, например, в банковских чеках. Минусы метода - начертание букв, передаваемых распознающей программе, должно быть ей заранее известно или по крайней мере быть подобным в имеющихся у нее образцах шрифтов (чтобы было, с чем сравнивать).

Второй подход - по идее, наиболее эффективный, поскольку не требует привязки к шрифту. Однако и наиболее сложный - ведь алгоритму необходимо «разложить» предполагаемые буквы на составляющие начертания. И не только в разложении трудности. Строки текста ведь не всегда идут строго прямо, особенно в сканированных источниках. Еще шрифты бывают разных размеров., а некоторые буквы похожи на другие буквы и на цифры. Как отличить английскую «а» от русской? Нужен уже словарь - программа будет пытаться сложить рас-познанные символы в слова и сверять каждое слово с образцами из словаря.
Каково современное состояние ПО для распознавания текста? Кого об этом ни спросишь, все называют одну и ту же программу - FineReader. В прошлом же называли CuneiForm. Но вообще-то CuneiForm никуда не исчезла. Более того, её исходники стали открыты под BSD-подобной лицензией...
Заканчиваете делать ремонт в своей новой квартире и Вам совершенно не до изучения Cuneiform? Что ж, тогда я рекомендую Вам прямо сейчас приобрести отличные люстры (http://brille.ua/lyustry/), которые идеально впишутся в ваш обновленный интерьер! А самый широкий ассортимент люстр Вы найдете на brille.ua.