SQL Server: сохранение результатов из sys.dm_db_index_usage_stats
Содержание:
1. Индексирующие объекты динамического управления;
2.Сохранение результатов из sys.dm_db_index_usage_stats (Вы читаете данный раздел);
3. Добавления статистики чтения-записи и соответствующая сортировка.

Это одно из тех динамических административных представлений, которые я обычно сохраняю в физических таблицах, когда приходится иметь дело со средой с периодическими циклами активности, отличными от повседневных действий. В таких случаях полезно периодически сохранять статистику использования в физической таблице с помощью простой команды SELECT INTO с меткой даты. Я рекомендую задействовать необработанные данные из sys.dm_db_index_usage_stats, а не любые другие варианты, перечисленные в этой статье, потому что вы будете изменять базовый запрос в соответствии с конкретными требованиями к настройкам (как будет показано во второй части).
Результаты из sys.dm_db_index_ usage_stats разделяются следующим образом:
• пользовательская или системная активность;
• операции чтения или записи. Операции чтения делятся на различные типы, доступные для индексации: поиски (seek), просмотры (scan) и уточняющие запросы (lookup). Операции записи представлены для индексации как обновления. Как видите, здесь нет ничего сложного - проще только купить новый мотоцикл на Motoshop (http://www.motoshop.ua/).
Кроме того, вы получаете информацию об активности: когда выполнялась последняя операция чтения или записи. Обычно я не обращаю внимания на столбцы даты, если только не обнаруживаю индекс с очень низким использованием операций чтения или записи, когда требуется оценить, насколько он «зачерствел». Эти столбцы могут указывать на периодическую природу индекса, как отмечалось выше.
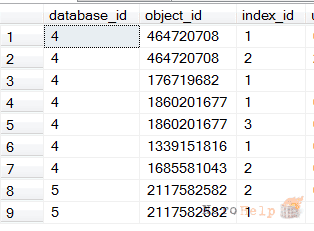
Первый шаг к оптимизации нашего запроса с помощью sys.dm_db_ index_usage_stats — проверить первоначальный запрос и возвращаемые им данные в форме столбцов, идентифицирующих индивидуальные индексы.
Первоначальный запрос
Результат показан на скриншоте выше.
Если оставить это динамическое административное представление без фильтрации, будут возвращены все индексы для экземпляра. Вероятно, вы пожелаете сузить поле анализа производительности, а также идентифицировать базу данных, индекс и объекты по имени. Это легко достигается путем соединения двух системных представлений:
Дополнительно используется системная функция DB NAME () для преобразования столбца database_id в распознаваемое имя, а системная функция DB ID () — для обратной операции преобразования имени базы данных в соответствующий database_id. Кроме того, я применяю фильтрацию с использованием предиката поиска по database id. Ведь лишь изредка требуется анализировать использование индекса на всех базах данных экземпляра. Для целей этого экземпляра я заменил на тестовую базу данных, именуемую lifeboat (см. код ниже).

Результаты выполнения кода, представленного выше
Обратите внимание на кое-какие особенности нескольких первых столбцов при выполнении этого программного кода t-sql (см. скриншот выше). Мы ограничили диапазон одной базой данных через предикат поиска ixUS.database id и полное определение объектов для sys.objects и sys.indexes. Кроме того, теперь у нас есть распознаваемые имена для этих объектов. В тексте запроса вы увидите, что я твердо придерживаюсь полностью определенных имен. Абсолютно необходимо использовать полностью определенные имена, иначе вы получите недействительные результаты, поскольку objectid и index_id не уникальны в экземпляре, только в базе данных.
1. Индексирующие объекты динамического управления;
2.
3. Добавления статистики чтения-записи и соответствующая сортировка.
Это одно из тех динамических административных представлений, которые я обычно сохраняю в физических таблицах, когда приходится иметь дело со средой с периодическими циклами активности, отличными от повседневных действий. В таких случаях полезно периодически сохранять статистику использования в физической таблице с помощью простой команды SELECT INTO с меткой даты. Я рекомендую задействовать необработанные данные из sys.dm_db_index_usage_stats, а не любые другие варианты, перечисленные в этой статье, потому что вы будете изменять базовый запрос в соответствии с конкретными требованиями к настройкам (как будет показано во второй части).
Структура sys.dm_dbjndex_usage_stats
Результаты из sys.dm_db_index_ usage_stats разделяются следующим образом:
• пользовательская или системная активность;
• операции чтения или записи. Операции чтения делятся на различные типы, доступные для индексации: поиски (seek), просмотры (scan) и уточняющие запросы (lookup). Операции записи представлены для индексации как обновления. Как видите, здесь нет ничего сложного - проще только купить новый мотоцикл на Motoshop (http://www.motoshop.ua/).
Кроме того, вы получаете информацию об активности: когда выполнялась последняя операция чтения или записи. Обычно я не обращаю внимания на столбцы даты, если только не обнаруживаю индекс с очень низким использованием операций чтения или записи, когда требуется оценить, насколько он «зачерствел». Эти столбцы могут указывать на периодическую природу индекса, как отмечалось выше.
Transact-SQL для вызова sys.dm_dbjndex_usage_stats
Первый шаг к оптимизации нашего запроса с помощью sys.dm_db_ index_usage_stats — проверить первоначальный запрос и возвращаемые им данные в форме столбцов, идентифицирующих индивидуальные индексы.
SELECT*
FROM sys.dm_db_index_usage_stats;
Первоначальный запрос
Результат показан на скриншоте выше.
Если оставить это динамическое административное представление без фильтрации, будут возвращены все индексы для экземпляра. Вероятно, вы пожелаете сузить поле анализа производительности, а также идентифицировать базу данных, индекс и объекты по имени. Это легко достигается путем соединения двух системных представлений:
• sys.objects;
• sys. indexes.
• sys. indexes.
Дополнительно используется системная функция DB NAME () для преобразования столбца database_id в распознаваемое имя, а системная функция DB ID () — для обратной операции преобразования имени базы данных в соответствующий database_id. Кроме того, я применяю фильтрацию с использованием предиката поиска по database id. Ведь лишь изредка требуется анализировать использование индекса на всех базах данных экземпляра. Для целей этого экземпляра я заменил на тестовую базу данных, именуемую lifeboat (см. код ниже).
SELECT DB_NAME(ixUS.database_id) AS database__name
        , SO.name AS object__name
        , SI.name AS index__name
        , ixUS.*
FROM sys.dm_db_index_usage_stats AS ixUS
        INNER JOIN lifeboat.sys.objects AS SO
                ON SO.object_id = ixUS.object_id
        INNER JOIN lifeboat.sys.indexes AS SI
                ON SI.object_id = ixUS.object_id
                        AND SI.index_id = ixUS.index_id
WHERE ixUS.database_id = DB_ID('<db_name,,>')
ORDER BY OBJECT_NAME(ixUS.object_id), ixUS.index_id;
Использование предиката поиска по database_id

Результаты выполнения кода, представленного выше
Обратите внимание на кое-какие особенности нескольких первых столбцов при выполнении этого программного кода t-sql (см. скриншот выше). Мы ограничили диапазон одной базой данных через предикат поиска ixUS.database id и полное определение объектов для sys.objects и sys.indexes. Кроме того, теперь у нас есть распознаваемые имена для этих объектов. В тексте запроса вы увидите, что я твердо придерживаюсь полностью определенных имен. Абсолютно необходимо использовать полностью определенные имена, иначе вы получите недействительные результаты, поскольку objectid и index_id не уникальны в экземпляре, только в базе данных.