Использование интеллектуальных инструментов импорта для избавления от файлов PST. Часть II
Содержание:
1. Часть I;
2.Часть II (Вы читаете данный раздел);
3. Часть III.

Ответ заключается использовании персональных методов работы с почтой и недоверии к ИТ, возможно, по причине строгих квот почтовых ящиков или низкой надежности серверов. Одни пользователи создают файлы PST, чтобы заархивировать элементы для выделенных проектов, другие — чтобы архивировать элементы на регулярной основе, в то время как у третьих есть своя фантастическая и по-своему оригинальная логика создания нового файла PST. Дело в том, что все это происходит «в поле», и компании, по всей вероятности, просто не понимают, какое большое количество корпоративных данных в реальности хранится в файлах PST, которые расположены на дисках, полностью контролируемых пользователями. Сканирование десятков тысяч рабочих станций в крупной компании может раскрыть сотни терабайтов файлов PST. И все эти данные невидимы и недоступны для корпоративного поиска и проверки на соответствие требованиям.


Поиск такого большого количества файлов PST и попытка выяснить, что с ними делать, может в итоге потребовать огромного количества времени системного администратора. Инструменты, которые смогут выполнить сканирование дисков на предмет поиска файлов PST, скопировать их в центральную область хранения, а затем подготовить к последующей обработке (производя, например, сканирование для исправления повреждений на уровне элементов посредством многократного выполнения утилиты SCANPST или другого программного кода) могут в итоге значительно сэкономить время. Особенно если есть возможность автоматизировать поток операций поиска, сбора и исправления. Прибавьте сюда дополнительную функциональность, например избавление от дубликатов во всем наборе файлов PST, и вы увидите, что стороннее программное обеспечение вполне оправдывает свою лицензионную стоимость.

В приведенном выше примере с компанией, обнаружившей сотни терабайтов данных в локальных файлах PST, также весьма вероятно, что в обнаруженной информации присутствует значительное количество продублированных данных. Напомню, что PST — это персональный файл, и если изначальное сообщение было отправлено ста адресатам, то в итоге сто его отдельных копий может находиться в ста различных файлах PST.
1. Часть I;
2.
3. Часть III.
Ответ заключается использовании персональных методов работы с почтой и недоверии к ИТ, возможно, по причине строгих квот почтовых ящиков или низкой надежности серверов. Одни пользователи создают файлы PST, чтобы заархивировать элементы для выделенных проектов, другие — чтобы архивировать элементы на регулярной основе, в то время как у третьих есть своя фантастическая и по-своему оригинальная логика создания нового файла PST. Дело в том, что все это происходит «в поле», и компании, по всей вероятности, просто не понимают, какое большое количество корпоративных данных в реальности хранится в файлах PST, которые расположены на дисках, полностью контролируемых пользователями. Сканирование десятков тысяч рабочих станций в крупной компании может раскрыть сотни терабайтов файлов PST. И все эти данные невидимы и недоступны для корпоративного поиска и проверки на соответствие требованиям.
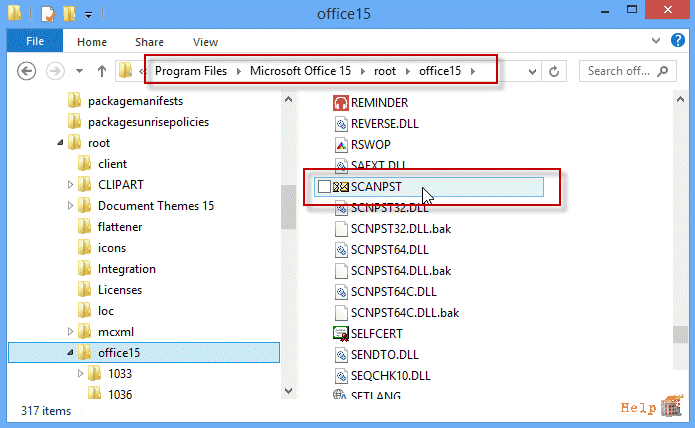
Поиск такого большого количества файлов PST и попытка выяснить, что с ними делать, может в итоге потребовать огромного количества времени системного администратора. Инструменты, которые смогут выполнить сканирование дисков на предмет поиска файлов PST, скопировать их в центральную область хранения, а затем подготовить к последующей обработке (производя, например, сканирование для исправления повреждений на уровне элементов посредством многократного выполнения утилиты SCANPST или другого программного кода) могут в итоге значительно сэкономить время. Особенно если есть возможность автоматизировать поток операций поиска, сбора и исправления. Прибавьте сюда дополнительную функциональность, например избавление от дубликатов во всем наборе файлов PST, и вы увидите, что стороннее программное обеспечение вполне оправдывает свою лицензионную стоимость.

В приведенном выше примере с компанией, обнаружившей сотни терабайтов данных в локальных файлах PST, также весьма вероятно, что в обнаруженной информации присутствует значительное количество продублированных данных. Напомню, что PST — это персональный файл, и если изначальное сообщение было отправлено ста адресатам, то в итоге сто его отдельных копий может находиться в ста различных файлах PST.