Кластеризованные индексы на основе GUID
Содержание:
1. Непоследовательность GUID (Вы читаете данный раздел);
2. Ключи кластеризации INT и BIGINT с использованием свойства IDENTITY.

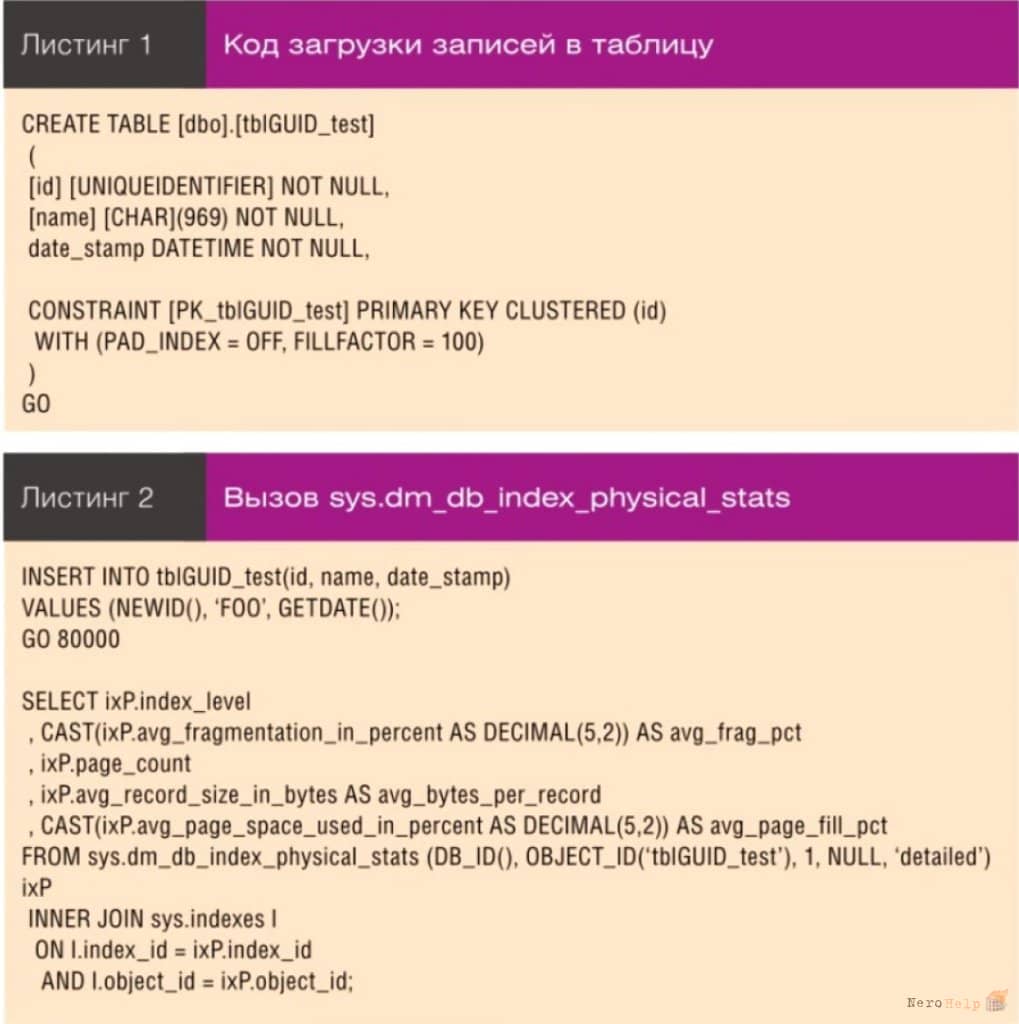
По умолчанию GUID не являются последовательными, и в этом заключается причина возникновения проблемы фрагментации. В качестве иллюстрации рассмотрим код, приведенный в листинге 1, реализующий загрузку записей в таблицу, где столбец GUID используется в качестве ключа кластеризованного индекса и ограничения первичного ключа. Если вставить строки в таблицу (каждая строка заканчивается по достижении длины в 1 000 байт с использованием приведенных выше типов данных), мы получим результаты вызова sys.dm_db_ index_physical_stats (см. листинг 2 и экран 1).

Уже с самого начала мы наблюдаем почти стопроцентную фрагментацию просто за счет применения GUID, а не последовательного процесса с использованием целых или длинных целых чисел в автоинкрементном режиме через свойство IDENTITY столбца таблицы. Чтобы увидеть, насколько быстро индекс на основе GUID становится фрагментированным, вернемся в начало. Усечем таблицу и выполним ввод 8 записей. Состояние фрагментации после ввода первых 8 записей показано на экране 2. Этого и следовало ожидать; однако нам еще предстоит заполнить страницу. Что произойдет, если добавить еще одну запись, мы видим на экране 3.
После ввода 9-й записи наступает разбиение первой страницы. Так как GUID поступают в кластеризованный индекс непоследовательно, страницы будут разбиваться, чтобы сбалансировать содержимое (примерно поровну). В таблице 9 строк, поэтому равного разбиения быть не может. Что будет, если добавить еще две строки? Поскольку страницы заполнены лишь на 55%, а мы знаем, что на странице помещается 9 строк, после этого добавления мы должны по-прежнему иметь две страницы на уровне листьев индекса, не так ли (см. экран 4)?

Однако мы получили еще одно разбиение страницы всего лишь после добавления двух строк. Пространство расходуется неэкономно, и при том, что используются 16-разрядные GUID, а не 4-байтные INT или 8-байтные BIGINT, и даже несмотря на то, что указан стопроцентный коэффициент заполнения индекса, мы не достигли этой отметки ни перед первым, ни перед вторым разбиением страницы. Проведем последний эксперимент.
Итак, у нас имеются три страницы индексов, заполненные примерно на 50%. Мы знаем, что на странице умещается девять строк и задан коэффициент заполнения 100%. Теоретически должна существовать возможность вставить 12 строк: (50% от 9 округляем до 4, так как нельзя вставить половину записи, и умножаем на 3). Как мы уже поняли, вероятность 99% заполнения этих трех страниц чрезвычайно мала без перестроения индексов, поэтому вопрос лишь в том, насколько сильно будет фрагментироваться индекс. Выясним это.

Добавив еще 12 строк в таблицу, получаем результат, показанный на экране 5. Странно! Добавление двух строк, 2/11 от общего их числа, вызвало разбиение страницы, то есть добавление еще одной страницы на уровне листьев индекса. Добавление еще 12 строк, то есть 12/23 от общего их числа, также вызвало разбиение страницы, но только одно, хотя доля страниц, добавленных в целом, в этом случае была намного больше, чем при добавлении 10-й и 11-й строк, в результате которого мы получили второе разбиение.
Проведем еще один маленький эксперимент: усечем таблицу и вновь добавим 23 строки. Поскольку используется команда GO#, строки добавляются в рамках единичных транзакций. Выводятся результаты вызова sys.dm_db_index_ physical_stats после вставки 8-й, 9-й, 11-й и 23-й строк. Поскольку мы проходим весь процесс заново, должны получиться аналогичные результаты (см. листинг 3 и экран 6).
По крайней мере, результаты близкие. Ввиду случайной природы значений GUID, получилась более благоприятная картина фрагментации внутри страниц; число строк на страницах осталось неизменным. Соответственно общая средняя степень заполнения страниц не изменилась; на данном этапе индекс остается четырехстраничным. Следовательно, выполнение сценария с усечением таблицы и повторной загрузкой 23 строк все же приводит к изменению числа страниц индекса и картины фрагментации. Я проделал это несколько раз и наблюдал среднюю степень фрагментации 50 или 75% на четырех страницах уровня листьев, заполненных примерно на 71%, но также получил индекс с пятью страницами на уровне листьев с 40-процентной средней степенью фрагментации, то есть 57-процентным средним заполнением. Другими словами, налицо последовательная непоследовательность. Я — администратор базы данных (DBA) и терпеть не могу последовательно непоследовательных вещей.
1.
2. Ключи кластеризации INT и BIGINT с использованием свойства IDENTITY.
Непоследовательность GUID
По умолчанию GUID не являются последовательными, и в этом заключается причина возникновения проблемы фрагментации. В качестве иллюстрации рассмотрим код, приведенный в листинге 1, реализующий загрузку записей в таблицу, где столбец GUID используется в качестве ключа кластеризованного индекса и ограничения первичного ключа. Если вставить строки в таблицу (каждая строка заканчивается по достижении длины в 1 000 байт с использованием приведенных выше типов данных), мы получим результаты вызова sys.dm_db_ index_physical_stats (см. листинг 2 и экран 1).
Уже с самого начала мы наблюдаем почти стопроцентную фрагментацию просто за счет применения GUID, а не последовательного процесса с использованием целых или длинных целых чисел в автоинкрементном режиме через свойство IDENTITY столбца таблицы. Чтобы увидеть, насколько быстро индекс на основе GUID становится фрагментированным, вернемся в начало. Усечем таблицу и выполним ввод 8 записей. Состояние фрагментации после ввода первых 8 записей показано на экране 2. Этого и следовало ожидать; однако нам еще предстоит заполнить страницу. Что произойдет, если добавить еще одну запись, мы видим на экране 3.
После ввода 9-й записи наступает разбиение первой страницы. Так как GUID поступают в кластеризованный индекс непоследовательно, страницы будут разбиваться, чтобы сбалансировать содержимое (примерно поровну). В таблице 9 строк, поэтому равного разбиения быть не может. Что будет, если добавить еще две строки? Поскольку страницы заполнены лишь на 55%, а мы знаем, что на странице помещается 9 строк, после этого добавления мы должны по-прежнему иметь две страницы на уровне листьев индекса, не так ли (см. экран 4)?
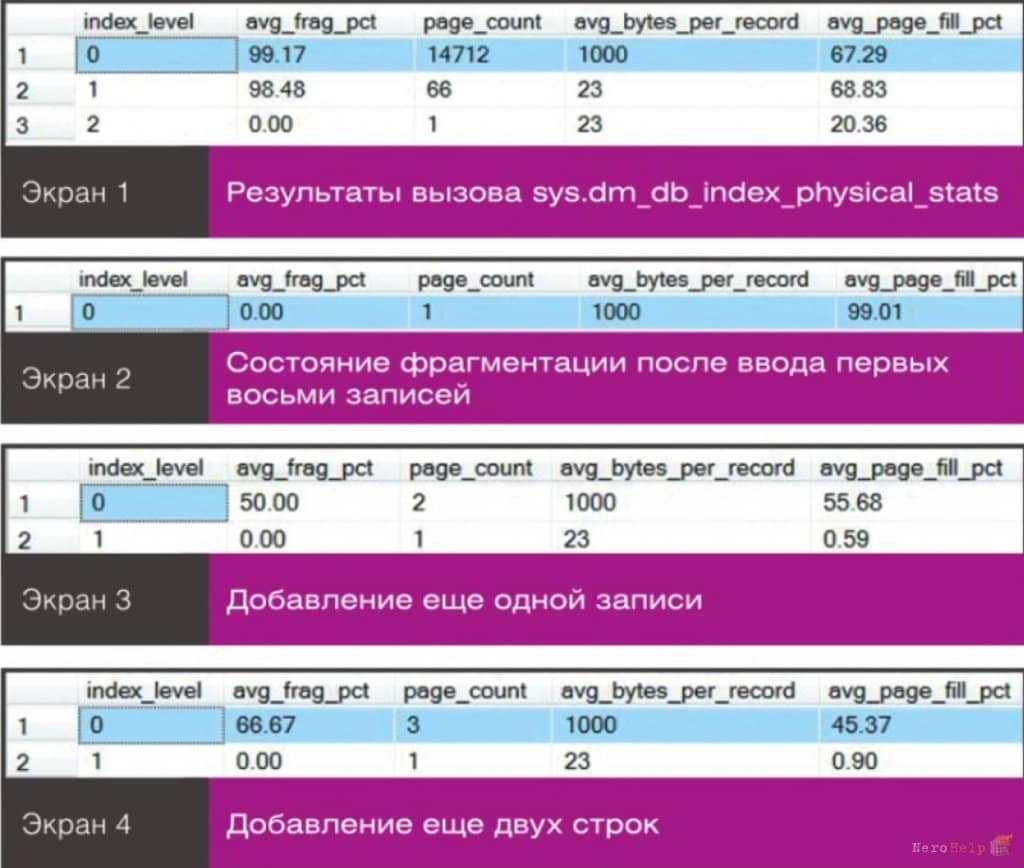
Однако мы получили еще одно разбиение страницы всего лишь после добавления двух строк. Пространство расходуется неэкономно, и при том, что используются 16-разрядные GUID, а не 4-байтные INT или 8-байтные BIGINT, и даже несмотря на то, что указан стопроцентный коэффициент заполнения индекса, мы не достигли этой отметки ни перед первым, ни перед вторым разбиением страницы. Проведем последний эксперимент.
Итак, у нас имеются три страницы индексов, заполненные примерно на 50%. Мы знаем, что на странице умещается девять строк и задан коэффициент заполнения 100%. Теоретически должна существовать возможность вставить 12 строк: (50% от 9 округляем до 4, так как нельзя вставить половину записи, и умножаем на 3). Как мы уже поняли, вероятность 99% заполнения этих трех страниц чрезвычайно мала без перестроения индексов, поэтому вопрос лишь в том, насколько сильно будет фрагментироваться индекс. Выясним это.
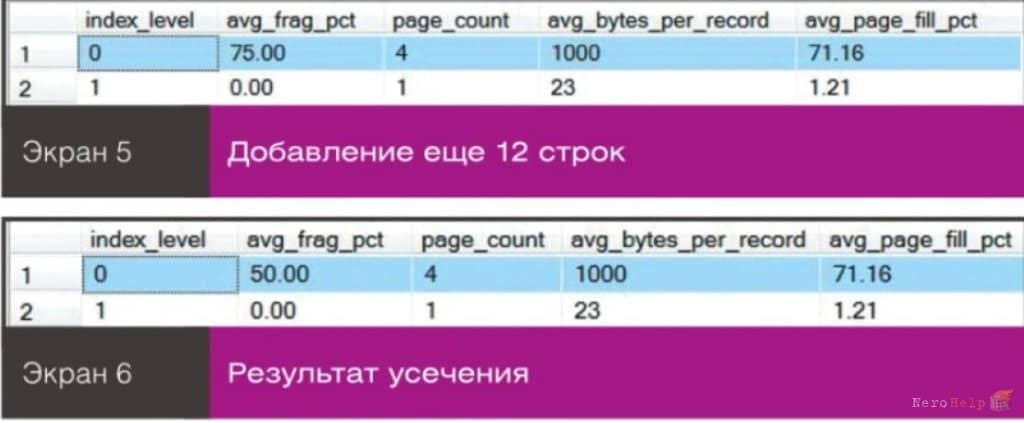
Добавив еще 12 строк в таблицу, получаем результат, показанный на экране 5. Странно! Добавление двух строк, 2/11 от общего их числа, вызвало разбиение страницы, то есть добавление еще одной страницы на уровне листьев индекса. Добавление еще 12 строк, то есть 12/23 от общего их числа, также вызвало разбиение страницы, но только одно, хотя доля страниц, добавленных в целом, в этом случае была намного больше, чем при добавлении 10-й и 11-й строк, в результате которого мы получили второе разбиение.
Проведем еще один маленький эксперимент: усечем таблицу и вновь добавим 23 строки. Поскольку используется команда GO#, строки добавляются в рамках единичных транзакций. Выводятся результаты вызова sys.dm_db_index_ physical_stats после вставки 8-й, 9-й, 11-й и 23-й строк. Поскольку мы проходим весь процесс заново, должны получиться аналогичные результаты (см. листинг 3 и экран 6).
По крайней мере, результаты близкие. Ввиду случайной природы значений GUID, получилась более благоприятная картина фрагментации внутри страниц; число строк на страницах осталось неизменным. Соответственно общая средняя степень заполнения страниц не изменилась; на данном этапе индекс остается четырехстраничным. Следовательно, выполнение сценария с усечением таблицы и повторной загрузкой 23 строк все же приводит к изменению числа страниц индекса и картины фрагментации. Я проделал это несколько раз и наблюдал среднюю степень фрагментации 50 или 75% на четырех страницах уровня листьев, заполненных примерно на 71%, но также получил индекс с пятью страницами на уровне листьев с 40-процентной средней степенью фрагментации, то есть 57-процентным средним заполнением. Другими словами, налицо последовательная непоследовательность. Я — администратор базы данных (DBA) и терпеть не могу последовательно непоследовательных вещей.